Expertise
Automatisation SEO : un pipeline contrôlé et réversible
L'automatisation SEO confie à des règles, des scripts, des workflows ou des modèles d'IA les tâches répétables du référencement : collecte, préparation, contrôle, publication et mesure. Elle ne remplace ni la décision éditoriale ni la preuve qu'une page mérite d'exister. Un pipeline fiable journalise chaque étape, publie par cohortes et prévoit son arrêt comme son retour en arrière.
Qu’est-ce que l’automatisation SEO ?
L’automatisation SEO consiste à transformer une tâche répétable du référencement en processus contrôlé. Des règles, des scripts, une plateforme no-code ou un modèle d’IA collectent une entrée, produisent une sortie, vérifient des conditions puis consignent le résultat. L’objectif n’est pas de supprimer le jugement humain, mais de réserver ce jugement aux décisions qui en ont réellement besoin.
Une automatisation utile possède quatre propriétés : son résultat est mesurable, son échec est visible, son action peut être interrompue et son effet peut être annulé. Sans ces propriétés, on accélère surtout la propagation des erreurs.
Quelles tâches SEO automatiser en priorité ?
Les meilleurs candidats ont des entrées prévisibles et une règle de sortie vérifiable. Plus une décision touche l’architecture, la réputation ou un contenu sensible, plus la validation humaine doit arriver tôt.
| Tâche | Automatisation raisonnable | Contrôle humain | Risque principal |
|---|---|---|---|
| Collecte GSC et crawl | extraction planifiée, normalisation, alertes | lecture des anomalies | donnée incomplète |
| Audit de métadonnées | détection des absences, doublons et longueurs | décision sur l’intention | correction mécanique |
| Brief éditorial | regroupement des requêtes et sources | angle, priorité, sources finales | brief générique |
| Maillage interne | candidats calculés par thème et parcours | pertinence du lien dans la page | liens artificiels |
| Génération de pages | remplissage depuis une donnée structurée | gabarit, cas limites, échantillon | contenu interchangeable |
| Publication | build, tests, preview et déploiement | autorisation du lot | propagation massive |
| Reporting | agrégation et comparaison de fenêtres | interprétation et décision | causalité inventée |
Il est souvent plus sûr d’automatiser d’abord la collecte, les tests et les alertes. Automatiser directement la publication donne un effet visible plus rapide, mais augmente aussi le rayon d’une erreur.
Le pipeline complet, de la collecte à la décision
Chaque étape produit un artefact observable pour la suivante. La mesure ne ferme pas la boucle toute seule : elle doit conduire à une décision écrite, maintenir, corriger, étendre ou revenir en arrière.
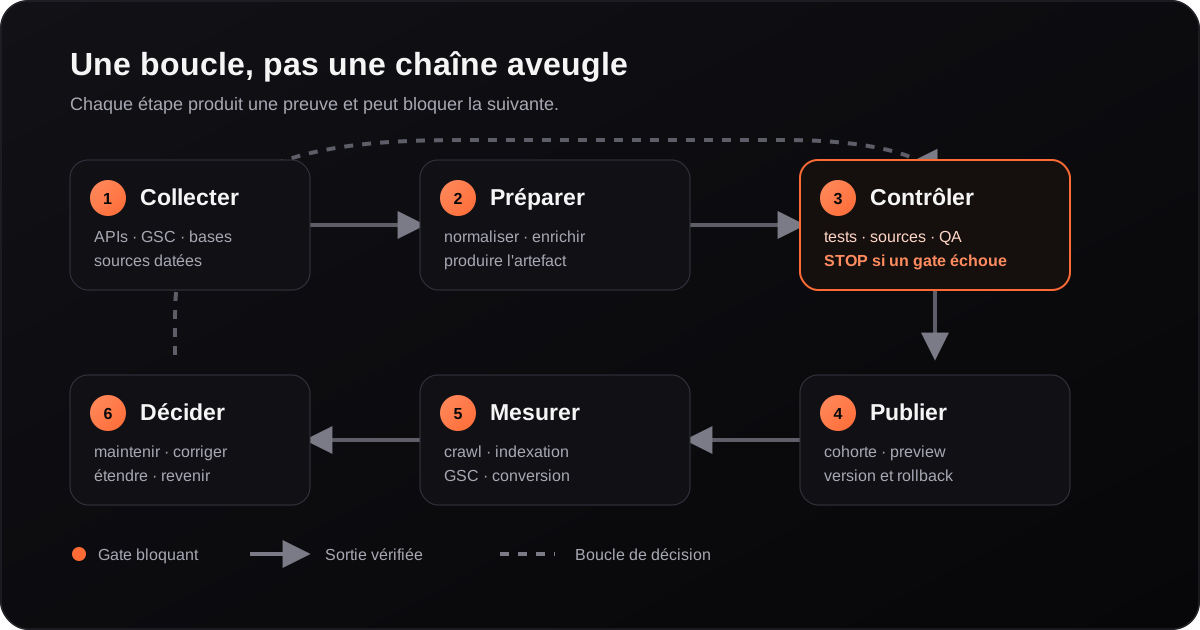
| Étape | Entrée | Sortie vérifiable | Condition de blocage |
|---|---|---|---|
| Collecter | API, base, référentiel, crawl | données datées et sourcées | source absente ou périmée |
| Préparer | données brutes | modèle normalisé | identifiant ou champ critique manquant |
| Contrôler | page et métadonnées | rapport de tests | intention, lien, canonical ou source invalide |
| Publier | lot validé | artefact versionné et preview | différence entre preview et production |
| Mesurer | logs, indexation, GSC, conversion | fenêtre comparable | définition ou période incompatible |
| Décider | preuves de la cohorte | maintenir, corriger, étendre ou rollback | propriétaire ou seuil non défini |
Exemple réel : surveiller 62 propriétés Search Console sans multiplier les onglets
Le portefeuille suivi au 20 août 2026 comprend 62 propriétés GSC. Un ingest planifié récupère les données, les rattache aux URL connues et calcule des fenêtres comparables. Le dashboard signale ensuite une chute d’impressions, une absence prolongée de crawl ou une position faible avec un volume déjà significatif. L’alerte prépare la décision ; elle ne modifie aucune page.
Sur la fenêtre finale du 22 juillet au 18 août 2026, ce périmètre a cumulé 532 616 impressions GSC. Ce nombre décrit une échelle d’observation, pas l’effet isolé d’un outil ni une promesse mensuelle. La période, les propriétés et la définition de la métrique doivent rester attachées au chiffre.
Tutoriel : repérer les pages SEO à renforcer depuis GSC
Voici un premier workflow d’automatisation SEO : transformer un export Search Console en liste de pages à examiner. Le résultat prépare une décision éditoriale ; il ne réécrit ni ne publie le site.
1. Préparer un export comparable
Utilisez la recherche Web, une fenêtre de 28 jours en données finales et les dimensions query, page, dans cet ordre. Pour un marché français, ajoutez le filtre pays fra. Conservez la requête API avec la réponse : un simple export de la table « Requêtes » de l’interface ne fournit pas nécessairement les couples requête/page.
Le fichier attendu contient deux clés : request pour les paramètres et rows pour les lignes de la réponse. La documentation de Search Analytics décrit les dimensions, les filtres et la pagination. Pour un grand export, parcourir les pages avec startRow ; même ainsi, l’API ne garantit pas toutes les lignes et certaines requêtes sont masquées. La somme des impressions par requête n’est pas le total de la propriété.
2. Exécuter la démonstration locale
Téléchargez le script opportunites-gsc.mjs et le jeu de données fictives dans le même dossier. Avec Node.js 22 ou plus récent, lancez :
node opportunites-gsc.mjs gsc-exemple-fictif.jsonAucune installation de bibliothèque, connexion Google ou clé API n’est nécessaire pour cette démonstration. Le script lit le fichier local et affiche du JSON dans le terminal. Pour vos données, remplacez seulement le nom du fichier ; gardez cet export privé sur votre ordinateur.
3. Lire le résultat avant de modifier une page
Les seuils de l’exercice sont au moins 20 impressions et une position moyenne comprise entre 4 et 25. Ils produisent une liste de travail, pas une prévision de clics. Le tri retient d’abord les couples les plus exposés et regroupe leurs requêtes par URL.
| Page fictive | Requête principale retenue | Impressions | Position | Décision à préparer |
|---|---|---|---|---|
| /atelier/ | rangement atelier | 120 | 12 | Vérifier la réponse et les exemples de rangement |
| /petites-pieces/ | organiser petites pieces | 80 | 9 | Comparer l’extrait et la promesse de la page |
Ces chiffres sont inventés pour l’exercice. Le premier groupe conserve aussi « boite rangement atelier » : 45 impressions, position 18. La page /garage/, en position 78, et la page /boite-plate/, avec quatre impressions, sont écartées par ces seuils. Un CTR faible reste à interpréter selon la position et la SERP ; il ne déclenche aucune correction automatique.
La requête « rangement atelier » apparaît aussi sur /guide/. Le champ otherPages le signale, même si cette seconde URL est hors des positions sélectionnées. Cela ne suffit pas à prouver une cannibalisation : comparer les intentions et plusieurs périodes avant toute fusion. Si rien ne passe les filtres, le résultat contient une liste vide.
4. Fermer la boucle avec une action vérifiable
Choisissez une page, observez la SERP, identifiez la réponse manquante, puis enrichissez-la. Notez la date et la modification. Relevez les mêmes couples requête/page à J+14 et J+28, avec les mêmes filtres. Un effet commercial se mesure ensuite avec les contacts confirmés, pas avec le nombre de lignes produites par le script.
Pour un workflow n8n, les étapes restent les mêmes : collecte authentifiée, contrôle du fichier, sélection, puis rapport soumis à revue. L’exemple fourni ici est un script local ; il ne contient ni workflow n8n à importer ni programmation prête à activer.
Transformer une liste de requêtes en décision éditoriale
La sortie du script reste une liste de candidats. Pour chaque URL retenue, écrivez d’abord ce que le visiteur doit pouvoir comprendre ou accomplir après sa lecture. Comparez cette promesse au contenu effectivement publié. Une page peut recevoir des impressions sur une expression sans répondre précisément à la question associée. Le rapprochement mérite une lecture, pas une réécriture automatique du titre pour reprendre tous les mots de la requête.
Ouvrez ensuite les pages voisines et les brouillons qui ciblent le même besoin. Notez les sections déjà disponibles, les exemples propres à chaque ressource et les liens qui les relient. Si le manque peut être comblé dans une page existante sans changer sa promesse, enrichissez cette page. Une nouvelle URL se justifie lorsqu’elle permet de traiter une tâche distincte, avec une réponse autonome et suffisamment documentée.
Prenons un exemple fictif : un site possède un guide pour choisir une étagère et une fiche expliquant ses dimensions. Le rapport fait remonter « profondeur étagère garage ». Ajouter une explication dans la fiche ou un lien depuis le guide peut suffire. Créer un troisième article qui répète les mêmes dimensions disperserait les informations à entretenir. La bonne décision dépend du contenu réel et de la demande, pas du nombre de suggestions produit par le modèle.
Consignez cette décision dans le brief avec quatre éléments : URL retenue, question centrale, pages proches et sujets volontairement exclus. Un rédacteur qui reprend le dossier doit comprendre pourquoi certaines informations restent ailleurs. Cette trace devient particulièrement utile quand plusieurs personnes ou agents travaillent simultanément : une réservation explicite de l’intention évite que deux brouillons avancent sur le même sujet.
Prévoir les résultats vides, les quotas et les reprises
Une automatisation doit distinguer une absence de résultat d’un échec de collecte. Une réponse valide contenant zéro ligne ne signifie pas la même chose qu’un refus d’authentification ou qu’un quota atteint. Si ces situations aboutissent toutes à un fichier vide, le rapport peut annoncer une disparition du trafic alors que le problème se trouve dans l’accès à la donnée. Conservez le statut de l’appel et la période demandée avec le résultat.
Un quota ou une indisponibilité ne doit pas déclencher une boucle illimitée. Prévoyez un nombre de tentatives, un espacement adapté aux indications du service et un état final explicite. Lorsque la donnée manque, le lot dépendant reste en attente. Le système peut poursuivre une autre tâche indépendante, mais ne doit ni inventer les lignes absentes ni présenter un ancien relevé comme une collecte du jour.
Le même principe s’applique aux modèles de langage. Une réponse reçue doit encore respecter le format attendu et les contrôles éditoriaux. Un texte bien formé peut contenir une date erronée ou une source qui ne soutient pas l’affirmation. Gardez séparément le résultat du modèle, les points soulevés par la revue et les corrections effectivement retenues. L’accord d’un modèle ne transforme pas une information en preuve primaire.
Enfin, une reprise ne doit pas publier deux fois le même travail. Associez le traitement à une référence stable, par exemple l’URL cible et la révision approuvée. Avant de relancer la publication, vérifiez si cette version est déjà présente et si son contrôle public a abouti. Il faut parfois reprendre uniquement la vérification après un déploiement réussi, plutôt que rejouer toute la chaîne parce que la dernière étape de suivi a échoué.
Limiter les accès et les données transmis aux outils
Donnez à chaque étape les droits nécessaires à sa tâche. Un script qui sélectionne des opportunités dans un export n’a pas besoin du droit de publier. Un outil de rédaction n’a pas besoin d’accéder aux coordonnées des prospects. Cette séparation rend les conséquences d’une erreur plus faciles à contenir et permet de relire un brouillon sans lui confier les moyens de modifier la production.
Dans le tutoriel proposé ici, le fichier de démonstration contient des données fictives et le script ne contacte aucun service. Pour un export réel, conservez les données dans l’espace de travail prévu par votre organisation. Évitez de joindre automatiquement le fichier complet à un outil externe lorsque quelques lignes agrégées suffisent à préparer le brief. Le contenu envoyé doit correspondre à la tâche, pas à tout ce que l’on peut extraire.
Les clés d’accès doivent rester dans un mécanisme de secrets approprié, séparé du contenu public et du dépôt. Les journaux peuvent indiquer un service, une durée, un code de réponse ou une référence de traitement sans reproduire les identifiants d’authentification. Avant de partager un rapport d’incident, contrôlez les champs qu’il contient : une trace destinée au diagnostic peut transporter davantage de données que prévu.
Définissez aussi qui peut approuver une modification sensible et comment cet accord est conservé. Une validation donnée pour enrichir un guide ne constitue pas une autorisation générale de supprimer des pages ou d’envoyer des messages à des tiers. L’automatisation doit transmettre le bon contexte à la personne responsable, avec une proposition concrète à examiner et un périmètre compréhensible.
Contrôler le document que le visiteur reçoit réellement
Un fichier source correct ne suffit pas à prouver que la page publiée est utilisable. Le gabarit peut masquer une section, une illustration peut manquer ou un tableau dépasser la largeur de l’écran. Examinez le document construit puis son rendu sur mobile et ordinateur. Parcourez les sections jusqu’en bas, ouvrez les réponses de la FAQ et utilisez les liens du sommaire au lieu de vérifier seulement la première capture.
Reliez les données structurées au contenu visible. Une FAQ déclarée dans le JSON-LD doit correspondre à des questions et réponses présentes dans la page. Une date de révision doit signaler un travail réel sur ce document ; la reconstruction technique du site ne justifie pas de rajeunir tous ses articles. Vérifiez aussi que l’illustration annoncée dans les métadonnées correspond bien à la ressource publiée.
Après le déploiement, contrôlez l’URL publique, son statut, sa canonical et ses directives d’indexation. Comparez son contenu à la version approuvée, puis vérifiez les destinations importantes et la présence dans le sitemap lorsqu’elle est attendue. Si le site utilise des fonctions pour ses formulaires ou son administration, le déploiement doit aussi préserver ces composants. Une page statique accessible ne prouve pas que tous les services ont été embarqués.
Cette vérification doit produire une preuve datée et une décision. Si la production correspond au document validé, vous pouvez clore cette livraison technique. Si un écart affecte la lecture ou le fonctionnement, corrigez-le ou revenez à une version connue avant d’annoncer la publication terminée. L’indexation et les résultats commerciaux restent ensuite des observations distinctes, à suivre sur les fenêtres définies.
Quatre termes utiles pour organiser le workflow
Idempotence. Une même demande peut être rejouée sans créer un doublon indésirable. Pour une publication, cela suppose de reconnaître le travail déjà exécuté et de reprendre l’étape manquante, plutôt que de générer une seconde URL.
Traçabilité. Chaque résultat reste rattaché à ses entrées, à sa date et à la décision qui l’a utilisé. Elle permet de retrouver pourquoi une page a été modifiée et quelle source soutenait un chiffre au moment de sa révision.
Contrôle bloquant. Une condition dont l’échec empêche l’action suivante. Il doit être précis et vérifiable : une source obligatoire absente ou une canonical inattendue peuvent bloquer une publication. Une appréciation vague comme « contenu premium » ne constitue pas un test reproductible.
Cohorte. Un groupe de pages suivies ensemble parce qu’elles partagent une intervention et une période d’observation définies. Gardez ses critères stables pendant la comparaison pour éviter de changer le groupe en fonction des résultats qui vous arrangent.
Une stack réelle, choisie selon la tâche
Le portefeuille ne repose pas sur un bouton unique. Les sites statiques rendent les artefacts versionnables, Cloudflare les diffuse, Supabase centralise certaines données, n8n orchestre des flux, et des scripts JavaScript ou Python exécutent les contrôles déterministes. Les modèles de langage interviennent lorsque la tâche demande une transformation de texte ou un classement sémantique, avec une sortie structurée et relue.
Static-first
Artefact construit avant publication, diff lisible et retour à une version connue.
Cloudflare
Diffusion edge, fonctions ciblées et déploiement relié au commit testé.
Supabase
Stockage des données utiles, des leads et des événements non sensibles.
n8n
Planification, branchement des étapes, retry limité et remontée d'erreur.
APIs de modèles
Brouillons et classifications encadrés par un schéma et des sources.
JavaScript et Python
Tests reproductibles pour les règles qui ne nécessitent aucune interprétation.
Le contrat de qualité avant publication
Avant de publier, chaque famille de pages doit déclarer ses entrées, ses sorties, ses seuils de rejet et son propriétaire. Les contrôles automatiques ne rendent pas une page utile par magie, mais empêchent une partie des erreurs répétables d’atteindre la production.
Contrat minimal
Source identifiée, intention distincte, champs obligatoires, réponse propre, liens internes résolus, canonical cohérente, données structurées valides, preview fidèle et rollback connu. Une page qui échoue à un contrôle bloquant n'est pas publiée.
| Contrôle | Échec détecté | Décision |
|---|---|---|
| Schéma de données | champ critique absent ou incohérent | rejeter la ligne |
| Valeur éditoriale | page interchangeable ou sans réponse propre | ne pas créer l’URL |
| Claims | chiffre sans période, source ou unité | bloquer la publication |
| Technique | lien mort, canonical ou JSON-LD invalide | bloquer le build |
| Cohorte | découverte ou indexation insuffisante | diagnostiquer avant d’étendre |
| Production | parcours public différent de l’artefact testé | revenir à la version précédente |
Où garder une validation humaine ?
Un humain doit rester propriétaire des changements qui redéfinissent le site : choix des intentions, nouvelles familles d’URL, redirections, canonical, claims commerciaux, sources sensibles et décision d’étendre un lot. Une validation humaine n’est utile que si elle intervient avant l’effet irréversible et dispose du contexte pour refuser.
La revue peut être échantillonnée lorsque le risque est homogène. Elle doit couvrir les cas riches, moyens et limites, pas seulement les pages les plus faciles à valider.
Publier par cohortes
Une cohorte pilote contient des cas représentatifs. Sa date de publication, son sitemap, ses visites de robots, ses états d’indexation, ses premières impressions et ses erreurs sont consignés. On compare ensuite les familles de pages, pas seulement le total du site. La cadence augmente seulement lorsque la qualité reste stable et que les seuils écrits avant le test sont atteints.
Le guide sur l’indexation de pages à grande échelle détaille la différence entre URL non découverte, découverte non crawlée, crawlée non indexée et indexée sans impression.
Arrêt sur erreur et rollback
Un pipeline fiable sait ne rien faire. Le circuit breaker interrompt le lot lorsqu’un invariant bloquant échoue : source indisponible, hausse anormale du nombre d’URL, données manquantes, test de lien rouge, différence entre preview et artefact ou erreur sur le parcours public.
Le rollback doit pointer vers une version précise, pas vers le souvenir d’un état antérieur. Pour un site versionné, cela signifie conserver le commit déployé, les migrations éventuelles, la commande de retour et le contrôle public qui prouve que l’ancienne version est revenue. Pour une donnée, il faut distinguer la correction d’une ligne, la republication du lot et la suppression d’URL, qui n’ont pas le même risque SEO.
Mesurer le ROI sans inventer une causalité
Le gain d’une automatisation ne se résume pas au nombre de pages produites. Il faut comparer, sur une même période, le temps humain évité, le coût des outils, le coût de maintenance et la valeur des erreurs empêchées. Le trafic ou les leads arrivent ensuite comme résultats du système complet, pas comme effet prouvé d’un workflow isolé.
| Mesure | Calcul utile | Limite |
|---|---|---|
| Temps économisé | durée manuelle de référence moins durée supervisée | qualité équivalente obligatoire |
| Coût d’exécution | APIs, infrastructure et revue | inclure les échecs et retries |
| Taux de rejet | sorties bloquées sur sorties totales | un rejet peut être sain |
| Délai de correction | détection jusqu’au retour au vert | dépend de l’observabilité |
| Résultat SEO | cohortes comparables dans GSC | ne prouve pas la causalité seule |
Ce qu’il ne faut pas automatiser
Il ne faut pas déléguer sans gate les décisions dont une erreur peut modifier durablement la réputation, l’indexation ou les droits d’une personne : publication d’un claim non sourcé, contenu réglementé, migration d’URL, suppression en masse, avis client, identité d’auteur ou communication externe. Le même principe s’applique lorsqu’une source est ambiguë : le système doit demander une décision, pas remplir le vide avec une supposition.
Ce que les preuves du portefeuille permettent de dire
Un lancement anonymisé a cumulé 10 707 clics GSC sur 50 jours calendaires. La série quotidienne, son manifeste et ses limites sont téléchargeables. D’autres actifs ont exploité de grands inventaires structurés. Ces observations démontrent une capacité d’exécution et de mesure ; elles ne garantissent ni un volume, ni un délai, ni une cadence sur un autre marché.
La bonne question n’est donc pas seulement « peut-on produire plus vite ? ». C’est : « quelle erreur le système détecte-t-il, quelle décision bloque-t-il et quelle preuve autorise l’étape suivante ? »
Questions fréquentes
Automatiser son SEO, est-ce que Google le pénalise ?
Google ne désigne pas l'automatisation comme une faute en soi. Ses règles visent notamment le contenu produit à grande échelle lorsqu'il sert principalement à manipuler les classements et n'apporte pas de valeur aux utilisateurs. Le procédé ne dispense donc jamais de contrôler l'intention, les faits, l'utilité et la qualité de chaque famille de pages.
Quels outils pour automatiser le SEO ?
La stack dépend de la tâche. Le portefeuille décrit ici utilise des sites statiques, Cloudflare pour la diffusion et le déploiement, Supabase pour les données, n8n pour l'orchestration, des APIs de modèles pour certaines transformations et des scripts JavaScript ou Python pour les contrôles déterministes. Un tableur ou une alerte simple reste préférable quand il suffit.
L'IA peut-elle rédiger des pages qui se positionnent ?
Elle peut participer à la préparation ou à la rédaction, sans garantir l'indexation ni le classement. Les résultats dépendent surtout de l'intention, de la donnée, des sources, du gabarit, de l'autorité du site et de la revue. Une sortie générée sans preuve ni contrôle reste facile à remplacer.
Comment éviter de publier du contenu de mauvaise qualité à l'échelle ?
Il faut combiner des rejets automatiques et une validation humaine proportionnée au risque : champs obligatoires, unicité de l'intention, liens et canonical, sources, cohérence des chiffres, rendu final et cas limites. Une page qui échoue à un contrôle bloquant ne doit pas atteindre la production.
À quel rythme publier ?
Il n'existe pas de cadence universelle. On publie un lot représentatif, puis on observe découverte, crawl, indexation, impressions, erreurs et conversion avant d'élargir. Le seuil d'accélération doit être écrit avant le test et dépendre des résultats observés.
Faut-il un CMS pour automatiser ?
Non. Un CMS peut fournir l'interface éditoriale, mais un dépôt de contenu et un générateur statique peuvent aussi constituer une chaîne complète. Le bon choix dépend des contributeurs, des validations, de la fréquence de mise à jour et du rollback attendu.